Você será hackeado em breve, e isso é um fato
O quanto você está preparado para o minuto seguinte em que isso ocorrer? O guia definitivo para todo engenheiro de software.
O quanto você está preparado para o minuto seguinte em que isso ocorrer? O guia definitivo para todo engenheiro de software.
Não é segredo para nenhum engenheiro que a gente anda comendo incidente de segurança no café da manhã, um dia depois do outro. Hoje mesmo, enquanto escrevo, três notícias estão abertas nas minhas abas, e as três dizem a mesma coisa de jeitos diferentes. Vou te contar as três e depois te entregar uma receita de bolo, de alguém que já viveu isso na prática algumas vezes na vida e que, pelo que parece, vai viver muito mais daqui em diante.
O café da manhã de hoje
A primeira é o PHP. Hoje o time do PHP publicou um aviso de segurança pedindo atualização imediata: as versões 8.5.12, 8.4.27, 8.3.36 e 8.2.35 corrigem duas vulnerabilidades críticas (CVE-2026-109618 e CVE-2026-109619) que permitem execução remota de código sem autenticação. O aviso diz que o risco é maior no mod_php, com um exploit demonstrado em que uma request sem login dispara o ataque antes de qualquer código da aplicação rodar. Quem encontrou foi a Wiz Research, e o relato deles é a parte que me fez parar: as falhas são bugs de memória no núcleo da linguagem, tratando mal erros fatais como falta de memória, e existiam há mais de uma década, afetando versões até o PHP 5.4. (Uma década, hein? Fico aqui me perguntando há quanto tempo as agências de segurança de governos, EUA, China, Israel, escolhe a sua, já sabiam disso e vinham explorando em silêncio 👀 #TeoriaDaConspiracao. É zuera, tá? Não tenho evidência nenhuma, só um bom senso de humor.) Eles demonstraram o RCE nas imagens de container mais recentes de WordPress, Drupal e Joomla. A linha do tempo é curta: primeira falha encontrada em 19 de agosto, RCE confirmado no Drupal no dia 20 e no WordPress no dia 21, reportado ao time do PHP no dia 24, correção pública só em 21 de outubro, 58 dias depois. A Wiz conta que usou modelos de IA em toda a pesquisa (achar a falha, escrever o exploit, validar o patch) e que um pesquisador fez em uma semana o que antes levaria um time meses. Esse último dado é deles, não meu, mas aponta para onde o vento sopra.
A segunda é a Railway, onde eu hospedo boa parte dos meus projetos pessoais. A empresa detectou atividade anômala em sistemas que guardam as variáveis de ambiente dos clientes: um terceiro não autorizado pode ter acessado variáveis criptografadas e, em alguns casos, obtido o conteúdo decifrado (chaves de API, credenciais de banco, credenciais de registry). Eles acreditam que faz parte de uma série de ataques a empresas de plataforma com o objetivo de chegar a provedores de inferência de IA (essa leitura é da Railway, eu não tenho como confirmar). Pela página de status, a investigação começou às 07:24 UTC do dia 21, o dashboard, a API e a CLI caíram, os builds foram pausados em todas as regiões e, na última atualização que li, ainda estavam pausados. Eu tenho vários PRs encadeados esperando essa liberação, alguns críticos, e já sei que quando liberar vou ter o trabalho longo de rotacionar chave por chave. Enquanto isso, os PRs críticos ficam lá na fila, envelhecendo como leite, não como vinho.
E aqui mora a armadilha que eu quero que você enxergue: a Railway recomenda rotacionar todas as variáveis, só que para a chave nova valer no meu serviço eu preciso de um deploy, e deploy é exatamente o que está bloqueado. A rotação das credenciais de bucket que eles mesmos fizeram caiu na mesma regra: as novas aparecem sozinhas, mas os serviços não conseguem ser reimplantados para usá-las até os builds voltarem. O seu plano de resposta a incidente depende do pipeline de outra empresa estar de pé, e você provavelmente nunca escreveu isso em nenhum documento.
A terceira é uma que eu li alguns meses atrás e que merece uma seção própria.
O caso do AppsFlyer
Quem é desenvolvedor mobile como eu já deve ter lidado com o AppsFlyer em algum momento. Ele está em uma quantidade enorme de apps (a própria empresa fala em cerca de 15 mil empresas e mais de 100 mil aplicativos mobile e web) fazendo o trabalho sujo da atribuição de tráfego e da integração entre as N plataformas de mídia paga, abstraindo dezenas de SDKs que teríamos que implementar na mão, um por um, cada qual com a sua regra, o que nós, devs mobile, odiamos com todas as nossas forças.
Em março de 2026 o alvo não foi o app, e sim o Web SDK deles, o script que os sites carregam de websdk.appsflyer.com. Segundo o BleepingComputer, o SDK mobile não foi afetado. A AppsFlyer diz, na FAQ do incidente, que nunca foi invadida: o que houve foi um “incidente no registrador de domínio”. Vamos fingir que confiamos plenamente no que fornecedores costumam dizer (afinal, sem confiança não existiria nenhuma relação humana), e mesmo assim o relato é grave. A análise da cside descreve que a conta do atacante no registrador mudou os nameservers do domínio da AWS Route 53 para outro provedor, e dali o tráfego de websdk.appsflyer.com passou a passar por servidores dele. A infraestrutura e os repositórios da empresa nunca precisaram ser tocados.
Como a conta do registrador foi comprometida? Não é público. A AppsFlyer diz que restaurou a autenticação em dois fatores da conta, o que sugere que o 2FA tinha deixado de proteger, mas não explica como. A hipótese clássica nesse tipo de caso é engenharia social: convencer o suporte do provedor (por telefone, o chamado vishing, ou por e-mail, com um pretexto convincente) a entregar o controle da conta. Eu estou falando de hipótese, não de fato, certo? Ninguém disse isso. (Meu chute de zuera é que o acesso era um login criado em 2019 por alguém que nem trabalha mais lá, mas isso é só o meu lado cínico falando.)
O que o atacante entregou no lugar do script é a parte elegante. Era um JavaScript ofuscado com um esquema próprio de base91 e uma tabela de 786 strings decodificadas em runtime, que mantinha o SDK funcionando normalmente enquanto trocava o window.fetch e usava um MutationObserver para vigiar o DOM atrás de endereços de carteira de cripto (Bitcoin, Ethereum, Solana, XRP e TRON), trocando pelos do atacante e enviando o original embora. (O que caralhos você acabou de dizer, Lukita? Resumindo: troca as carteiras originais pelas minhas. Na voz do atacante, claro.) Os pesquisadores relatam que ele variava o esquema de ofuscação e as carteiras, o que derrotava assinaturas estáticas. Para 99% dos sites isso passou despercebido. O primeiro alerta veio de pesquisadores (a Profero encontrou o payload no dia 9) e de usuários reclamando no Reddit, segundo o BleepingComputer.
Um site com SRI (o hash do script na tag) seria poupado. Só que o próprio fornecedor te pede para não fazer isso, porque você teria que atualizar o hash a cada versão nova, e esses scripts mudam dezenas de vezes por dia, com teste A/B e tudo mais. Seu marketing também não quer saber de demorar para atualizar aquele script ultra duvidoso de um site que promete uma ferramenta revolucionária e gratuita, né? A CSP ajudaria menos do que parece neste caso específico: o domínio sequestrado era justamente o que você tinha autorizado.
O legal de tudo isso é que a IA também está aí para o bem. O script é o do paste que circulou no thread do Hacker News: uma linha só, com 173 mil caracteres, totalmente ofuscado. Os cinco endereços de carteira e os dois endpoints dele são exatamente os que a Profero publicou como IOCs, então é o mesmo ataque. Caso queira ver o script com seus próprios olhos, está no pastebin, é seguro, eu juro (desde que você não o rode, é claro). (E se você conseguir ler o que ele faz sem ajuda, me conta como, seu MONSTRO!)
No dia do incidente (até para investigar se isso poderia nos afetar no app mobile, e é sobre essa prontidão que explicarei mais a fundo no artigo) eu joguei esse mesmo script no Gemini e perguntei o que ele faz. Essa foi a resposta (texto original, sem edição):
Diferente do script anterior, que era uma ferramenta legítima de marketing (AppsFlyer), este script é malicioso (ou, no mínimo, um adware altamente agressivo). Trata-se de um código profundamente ofuscado cujo comportamento principal aponta para um Sequestrador de Links de Afiliados (Affiliate Link Hijacker). Ele foi projetado especificamente para esconder suas intenções de antivírus, adblockers e desenvolvedores que tentem lê-lo.
Ver a resposta completa
Aqui está a engenharia reversa do que ele faz por debaixo dos panos:
1. Motor de Desofuscação (Descriptografia em tempo de execução). Toda a primeira metade do script (com variáveis como AlxhLg6, o57x3o, funções com ^, <<, >>=) é um motor de criptografia customizado. As strings reais do código (como URLs, nomes de eventos e expressões regulares) não estão no texto. Elas são montadas e decodificadas na memória apenas no exato momento em que o script precisa usá-las. Isso é uma técnica clássica de evasão.
2. Busca de “Carga Útil” (Payload C2). A função assíncrona p58Xob() faz uma requisição fetch silenciosa para um servidor de controle. Ela baixa um JSON e salva as variáveis de resposta (e, b, s, x, r) em um objeto de configuração global invisível na aba window. Essas variáveis geralmente contêm os IDs de afiliados atualizados do invasor.
3. Sequestro de Cliques (Link Hijacking). O núcleo do ataque acontece na parte final, onde o script adiciona Event Listeners no DOM (frequentemente escutando eventos de click ou submit).
- Quando o usuário clica em um link no seu site, o script intercepta a ação.
- Ele usa expressões regulares dinâmicas para verificar se o link de destino é de um e-commerce famoso (como Amazon, Shopee, AliExpress, etc.).
- Se for, ele reescreve silenciosamente a URL para injetar o código de afiliado do invasor antes de redirecionar o usuário. Assim, se o usuário comprar algo, a comissão vai para o dono deste script malicioso.
4. Interceptação de Rede Profunda. O código também possui estruturas pesadas para interceptar as APIs nativas do navegador (fetch e XMLHttpRequest). Ele sobrescreve essas APIs para poder ler e modificar respostas de rede em tempo real, garantindo que consiga injetar seus códigos mesmo em links gerados dinamicamente por aplicações modernas (como React ou Angular).
5. Telemetria e Rastreamento. A função m3hlJy1() é usada para espionagem. Toda vez que ele intercepta e altera um link com sucesso, ele agrupa a URL original, o timestamp, a URL fraudada e envia isso de volta em base64 para o servidor do atacante, contabilizando quantas comissões eles roubaram.
Resumo da Ópera: se você encontrou esse script no seu site, você sofreu uma injeção de código. Isso geralmente ocorre através de um plugin de terceiros comprometido, um pacote NPM infectado (supply chain attack) ou uma vulnerabilidade de XSS. Você gostaria de ajuda com estratégias para rastrear a origem dessa injeção de código no seu projeto?
Convincente, né? Bem escrita, cheia de certeza, e quase toda errada no que importa. Ele acertou o que dá para ver sem decodificar nada: tem um motor de desofuscação em runtime, uma função (p58Xob) que busca configuração num servidor, a interceptação de fetch e XHR e uma função de telemetria (m3hlJy1). Errou tudo o que as strings escondem. Lado a lado com o que está no arquivo:
| O Gemini disse | O que está no arquivo |
|---|---|
| Sequestra links de afiliado de e-commerce (Amazon, Shopee, AliExpress) | Troca endereços de carteira de cripto. As únicas URLs do arquivo são websdk.appsflyer.com/v1/api/... |
Escuta eventos de click ou submit | Escuta input e paste em campos de endereço de carteira, e intercepta fetch e XHR |
e, b, s, x e r são IDs de afiliados | São endereços de carteira: Ethereum, Bitcoin, Solana, XRP e Tron |
| Telemetria em base64, com a URL fraudada | XOR com a chave "ass", com o endereço original da vítima, e que nem chega a ser enviada por causa de variáveis não declaradas |
| Provável injeção no seu site (plugin, NPM ou XSS) | O site da vítima não precisou ser tocado: o domínio do fornecedor é que foi sequestrado |
(As análises publicadas pela cside e pela Profero também falam de troca de carteiras de cripto, não de links de afiliados.) O pior é a última parte: o Gemini te mandaria procurar um plugin, um pacote NPM ou um XSS no seu site, quando o problema era o domínio do fornecedor. Resposta confiante e errada na etapa de impacto é o que faz você gastar a primeira hora do incidente olhando para o lugar errado.
Daí peguei o mesmo script e dei para o Claude. E antes que alguém grite: não é uma comparação justa. O Gemini era um modelo de março, e o Claude que respondeu agora é um modelo atual (o Claude Sonnet 5.5), usado sete meses depois. Além disso, o Gemini recebeu o texto numa conversa, já o Claude Code recebeu o arquivo, escreveu um decodificador para a tabela de strings e leu o resultado (nada do script foi executado, só lido). A lição não é de marca: é que, sem decodificar as strings, um modelo está chutando o significado a partir de nomes e estrutura. Essa foi a resposta:
Resposta curta: é um clipper de criptomoedas que roda no navegador. Ele troca endereços de carteira (Bitcoin, Ethereum, Solana, XRP e Tron) pelos do atacante em dois lugares: nos campos de formulário que a pessoa digita ou cola, e nas requests fetch e XHR que a própria página envia. O tipo de ataque é supply chain: o script não foi plantado no site da vítima, foi entregue por um domínio de confiança (websdk.appsflyer.com) que o atacante controlava.
Ver a análise completa
1. A ofuscação (o que você vê se abrir o arquivo). São cinco camadas. Primeiro, as strings ficam em tabelas codificadas num base91 customizado, com 73 alfabetos embaralhados diferentes (um por escopo), decodificadas só na hora do uso e guardadas em cache: nenhum nome de API como fetch, replace ou MutationObserver aparece como texto, vira algo como iVp0dU7(693). Segundo, uma tabela de 318 constantes numéricas (AlxhLg6[12] no lugar de 91), para que até os números sumam. Terceiro, identificadores renomeados para lixo (fQKJYA_, o57x3o) e expressões achatadas dentro de uma função eD9kupT() que não faz nada (ela se redefine como função vazia), o que quebra a leitura linear. Quarto, para achar o objeto global ele tenta globalThis, global, window e new Function("return this")(), então o mesmo arquivo roda no navegador e no Node. Quinto, 20 blocos de código morto de enchimento (cache LRU, soma de listas ligadas, three sum, anagrama, SHA-256 e outros), cada um atrás de um if ("nome-aleatório" in RkSCPk), onde RkSCPk é uma função vazia: a condição nunca é verdadeira, então nada daquilo roda, só engorda o arquivo e dilui a leitura. A técnica é ofuscação, não criptografia: o alfabeto de cada tabela está no próprio arquivo, então quem tem o arquivo tem tudo para decodificar. Ela serve para derrotar assinaturas estáticas e a leitura humana rápida, e é justamente o tipo de trabalho repetitivo que uma IA faz bem.
2. NetHooksmith (cerca de 83% do arquivo). É uma biblioteca genérica de interceptação de rede embutida. O install({fetch: true, xhr: true}) troca window.fetch e XMLHttpRequest por versões que passam por hooks before e after; cada hook consegue ler o body da request (getRequestBody), reescrevê-lo (setBody), mudar cabeçalhos e até devolver uma resposta sintética ou bloquear. Isso é API hooking (monkey patching). A mesma biblioteca traz o ActuateElements, um observador de DOM (MutationObserver) que executa uma função em todo elemento que bate com um seletor CSS, inclusive os criados depois, e o XorCipherBytes, um XOR com chave repetida.
3. O que realmente roda (só 3,8% do arquivo, os últimos ~6,5 mil caracteres). Em ordem:
- Cria
window.walletAddressescom cinco endereços do atacante escritos direto no código, um por rede. - Instala os hooks de
fetche XHR. - Faz um GET em
https://websdk.appsflyer.com/v1/api/plugine, se vier JSON, sobrescreve os endereços com os do servidor (campose,b,s,xer, cada um com uma). Ou seja: o atacante troca as carteiras quando quiser sem mexer no script, e os embutidos viram reserva se esse GET falhar. Ele ainda escreve “Generating new wallets…” no console. - Registra cinco hooks de rede, um por rede, que reescrevem o body da request antes de ela sair: qualquer coisa no formato de endereço vira o endereço do atacante.
- Observa os campos
input[placeholder*='address'],input[name*='wallet'],input[id*='address']etextarea[placeholder*='address']. A cadainput, se o valor parece um endereço, troca ovaluedo campo pelo do atacante. - Escuta o
pastee dispara uminput100 ms depois, para colar um endereço também cair no passo anterior. - Por fim, define
window.AFcom um único métodotrackque só fazconsole.log, e reexecuta a filaAF.q. É um stub da API do SDK para o código do site que chama o AppsFlyer não quebrar. O arquivo não tem nenhuma função de atribuição.
| Rede | Expressão | Onde é usada |
|---|---|---|
| Bitcoin | [13][a-km-zA-HJ-NP-Z1-9]{25,34} e bc1[a-z0-9]{39,59} | rede (só POST) e campo |
| Ethereum | 0x[a-fA-F0-9]{40} | rede (só POST) e campo |
| Tron | T[1-9A-HJ-NP-Za-km-z]{33} | rede e campo (se a URL tiver “tron” ou “trx”) |
| XRP | r[1-9A-HJ-NP-Za-km-z]{24,35} | só na rede |
| Solana | [1-9A-HJ-NP-Za-km-z]{32,44} | rede e campo (se a URL tiver “solana”, “phantom” ou “sol”) |
Repare que a expressão da Solana casa qualquer string base58 de 32 a 44 caracteres, por isso o filtro por URL no campo. Na rede não há esse filtro.
4. O envio dos dados (e um bug). A função m3hlJy1 monta um JSON com o tipo (btc_wallet_hijacked, eth_wallet_hijacked…), o timestamp, a URL da página e o endereço original da vítima, “cifra” com XOR de chave "ass" (uma cifra de brinquedo, a chave está no arquivo) e faria um GET em /v1/api/process?rd=...&a=.... Só que, neste arquivo, ela usa timestamp e encryptedData, que não são declaradas em lugar nenhum. Em JavaScript isso é um ReferenceError antes do fetch, então neste build o endereço original nunca é enviado. A troca do endereço acontece antes dessa chamada, então segue funcionando. Não dá para dizer se outras variantes têm o mesmo erro: a análise da cside descreve o envio como funcional na que ela estudou.
5. O que não está no arquivo. Nas strings que consegui decodificar não há leitura de cookies, localStorage, senha, cartão ou teclado, e ele não lê a área de transferência diretamente (só reage ao paste do campo). Também não dá para saber, só pelo arquivo, como o atacante assumiu o domínio nem por quanto tempo o script ficou no ar.
6. Onde ele impacta. Quem sofre é o visitante do site, não o dono do site e não o app mobile. O script roda com os mesmos privilégios da página que o carregou, no navegador de quem abriu uma página com o Web SDK enquanto o domínio estava nas mãos do atacante. Em telas sem endereço de carteira ele fica inerte; o dano está em saque de exchange, pagamento em cripto, painel de carteira e dapp. Há dois caminhos. No campo de formulário, a pessoa até vê o endereço mudar se prestar atenção. Na rede, a troca acontece depois da tela e antes de a request sair, e nada na tela muda: é o caminho mais perigoso. Quem paga é o usuário final (transação em blockchain não tem estorno) e, depois, a reputação do site que carregou um script de terceiro.
7. O que pegaria isso. SRI, se o SDK fosse um arquivo fixo; monitoramento de mudança no conteúdo dos scripts de terceiros; e confirmação do endereço fora do navegador (hardware wallet, lista de endereços de saque aprovados). CSP não ajudaria: os dois endpoints são do domínio que o site já tinha autorizado.
O problema é que quem ataca tem a mesma IA. Ler JS minificado e ofuscado, desofuscar APK e binário, tudo isso virou tarefa de curso de informática do ensino médio com uma IA na mão, para os dois lados (desde que ela decodifique antes de chutar).
A web de hoje: o atacante sabe que o seu site está no ar antes de você
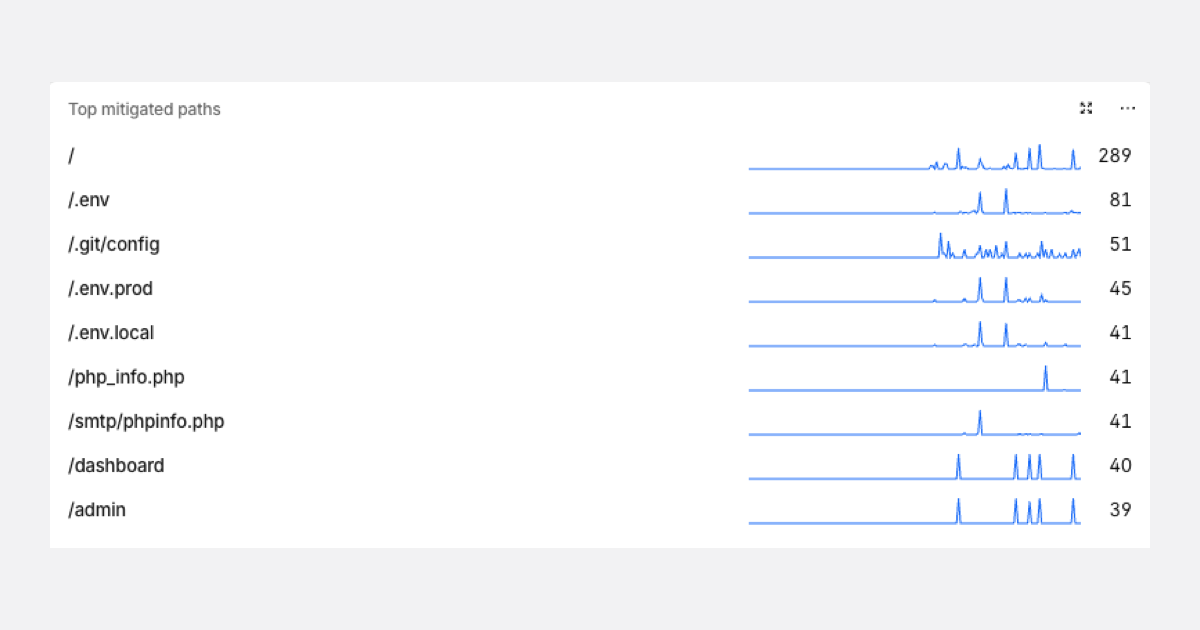
Esse print é do painel de segurança de um serviço novo que eu subi (era Next e Rust, nada de PHP). É a lista dos caminhos mais mitigados, ou seja, bloqueados. Tão rápido quanto o DNS começou a respondê-lo, vários bots já começaram a varrer várias URLs conhecidas: /.git/config, /.env e as variações .env.prod e .env.local, /php_info.php, /smtp/phpinfo.php, /dashboard e /admin.
 Top mitigated paths de um serviço que acabou de entrar no ar (os números são requests bloqueadas).
Repare no que ninguém ali quer: nenhum bot tem interesse no meu produto, e nenhum sabe que o meu serviço é em Rust. Eles chutam arquivo de configuração esquecido, credencial no repositório, página de debug de uma stack que eu nem uso e painel de admin, em tudo que responde. É barato, é em massa e é automático.
Resumindo, o atacante sabe que o seu site está no ar muitas vezes primeiro que você. Como? Eu não medi qual caminho me entregou, então vai como hipótese, mas existem vários: os logs de Certificate Transparency (todo certificado TLS emitido é publicado num log público, e tem gente ouvindo esse fluxo em tempo real), DNS passivo e varredura contínua de faixas inteiras de IP. Um certificado wildcard esconde o nome do subdomínio nos logs, o que ajuda um pouco, mas não resolve.
Sabe aquela Cloud Run, Firebase Function ou AWS Lambda que você deixa aberta publicamente rapidinho só para receber um webhook? Aquele artifact com HTML super bonito que o Claude gera, cheio de dado sensível, e que você coloca público para compartilhar com a galera do trampo o relatório que você puxou? Então, isso ESTÁ SENDO LIDO assim que fica disponível para todo mundo. O mecanismo varia (uma URL que ninguém conhece demora mais para ser achada, mas link escapa por histórico de navegador, extensão, chat e log), então a pergunta certa não é “quem vai achar?”, e sim “o que alguém leva se achar?”.
Se tudo que fica no ar é lido na hora, a primeira defesa é não deixar no ar o que não precisa estar. Vamos à receita.
Por que o jeito tradicional não está sendo suficiente
Vou dar a minha opinião, e ela é só isso, uma opinião de quem vê o dia a dia e não tem um estudo para citar. As ferramentas tradicionais (scan de código, SAST, DAST, análise de dependências) foram desenhadas para um mundo em que o atacante era lento e o código também. Nenhum dos dois é mais verdade. Os modelos de fronteira exploram hipóteses que ninguém tinha tempo de explorar, e do outro lado nós geramos feature e código com as mesmas IAs, numa velocidade enorme, entendendo cada vez menos do que foi feito. Quanto mais código que ninguém leu em produção, maior a superfície, e menos tempo para quem defende.
Tudo isso leva a um só caminho, e é o que dá título a este texto: você será hackeado em breve, e isso é um fato. A pergunta útil deixa de ser “como eu evito?” e passa a ser “o que acontece nos 60 minutos seguintes?”. Separei a receita em três momentos: antes, durante e depois.
1. Antes da produção
Nada aqui impede o incidente sozinho. O objetivo é reduzir o que o atacante consegue fazer, aumentar o custo dele, e principalmente fazer você perceber rápido. Agrupei do jeito que eu penso nisso, e com o que eu faria primeiro em cada uma, para você sair daqui sabendo por onde começar.
VPN e rede interna: nem tudo precisa estar na internet
O jeito mais barato de não ser varrido é não aparecer na varredura. Painel de admin, dashboard, Grafana, Swagger, endpoints de debug e de métricas (/actuator, /metrics, /debug/pprof), staging, banco, Redis, SSH: nada disso precisa de IP público, e o /admin e o /dashboard já estão na lista de caminhos do print lá em cima.
A primeira camada é a VPN. O WireGuard (direto, ou por cima de um serviço como o Tailscale) deixa cada pessoa com a própria chave, que você revoga no dia em que ela sai da empresa, e o acesso aos serviços internos passa a exigir estar dentro da rede. Mais moderno que isso é o acesso por identidade, o chamado Zero Trust: em vez de “quem está na rede entra”, é “quem é você, em qual dispositivo, e pode acessar isso?”. É o que fazem o Cloudflare Access, o Tailscale, o Identity-Aware Proxy do Google e o AWS Verified Access, todos na frente de ferramenta interna, com o SSO da empresa e 2FA.
Na nuvem, o básico é: banco e serviços internos em subnet privada (VPC) sem IP público, security group fechado por padrão (nunca 0.0.0.0/0 para SSH, MySQL, Postgres, Redis ou MongoDB) e nada de bastion com a porta aberta. O SSM Session Manager na AWS, o IAP TCP forwarding no Google Cloud e o Azure Bastion no Azure dão acesso por identidade, sem expor a porta 22.
E o webhook, que precisa mesmo ser público? Aí a ideia é deixar a superfície mínima. A Cloud Run, a Firebase Function ou a Lambda recebe, verifica a assinatura do provedor (HMAC, como o Stripe-Signature ou o X-Hub-Signature-256) e a data da mensagem, rejeita o que não bater, joga o payload numa fila (Pub/Sub, SQS) e responde. Nada de regra de negócio, nada de segredo além do segredo de assinatura, e o que faz o trabalho de verdade fica privado (--no-allow-unauthenticated na Cloud Run, invoker privado nas Firebase Functions, auth AWS_IAM na URL da Lambda). Quando o provedor publica a lista de IPs de origem, use também.
O artifact, o relatório e o dashboard bonito com dado sensível seguem a mesma regra: compartilhe com login (o SSO da empresa), com expiração, ou tire o dado sensível antes. Link “secreto” não é controle de acesso.
Por fim, o limite: VPN não é bala de prata. Appliances de VPN têm sido alvo frequente de exploração, e uma rede interna plana, onde quem entra enxerga tudo, transforma uma credencial vazada em acesso a todos os sistemas. Segmente a rede, mantenha privilégio mínimo mesmo dentro dela, use mTLS entre serviços e registre o que acontece lá dentro também. Rede interna não é lugar confiável.
Quem está chamando a sua API?
Um API gateway na frente de tudo dá um ponto único de autenticação, rate limit, validação de schema e log. Quanto menos caminhos para dentro, melhor. Eu já usei Akamai, Cloudflare e Kong, e às vezes a combinação de mais de um, em camadas: Akamai ou Cloudflare no edge (CDN, WAF, bot manager, DDoS) e o Kong dentro, perto dos serviços, cuidando de autenticação, rate limit por consumer e plugins.
O WAF olha o HTTP e aplica regras, e o bot manager decide se quem chama é uma pessoa ou um script. As regras básicas que valem em quase qualquer lugar: bloquear os métodos HTTP que a sua API não usa; bloquear o acesso a arquivos que nunca deveriam ser públicos (/.env, /.git, o que o print lá em cima mostra); aplicar rate limit no login (algo como 5 tentativas por 10 segundos, por IP); e dar um challenge para o tráfego com cara de bot (na Cloudflare, por exemplo, pelo score do Bot Management). Boa parte disso dá para automatizar conectando o Swagger/OpenAPI da sua API: a especificação já diz quais caminhos, métodos, parâmetros e formatos de body existem, então o gateway e o WAF passam a aceitar só isso (o que não está no contrato, como o /.env, é barrado de cara). E se o contrato é atualizado no pipeline a cada deploy, as regras acompanham a API sem ninguém mexer à mão, o que facilita manter tudo atualizado. A Cloudflare tem o Schema Validation no API Shield, a Akamai aceita definições de API no App & API Protector e o Kong importa a spec com o decK (deck file openapi2kong), por exemplo. Comece em modo de log, porque contrato desatualizado bloqueia tráfego legítimo (mais um motivo para mantê-lo em dia).
Já o bot manager vai além de IP. Os sinais que ele costuma combinar: verified bots (o Googlebot se confirma por reverse DNS, não pelo User-Agent), fingerprint de TLS (JA3/JA4, porque curl e Chrome falam TLS de jeitos diferentes), headers que faltam ou sobram (HeadlessChrome no User-Agent, ausência de Accept-Language) e comportamento (um IP testando mil contas, ou mil IPs testando uma conta, que é o credential stuffing). A escada de resposta é sempre a mesma: log, challenge, block.
O Turnstile, o reCAPTCHA Enterprise e os desafios com proof of work entram como custo para o bot e quase nenhum para o humano. O erro clássico é validar só no front. O token precisa ser verificado no backend, chamando a API de verificação do provedor com o seu secret.
O proof of work é a mesma ideia sem terceiro: o servidor manda um challenge e o cliente precisa achar um nonce cujo hash comece com N zeros. Para uma pessoa custa milissegundos, para um bot rodando milhões de requests custa caro.
- Integridade do cliente: no mobile, App Check, App Attest e Play Integrity dizem ao seu backend se quem chama é o seu app mesmo, íntegro e em dispositivo confiável. É autoridade sobre o cliente, não só sobre o usuário.
- mTLS entre serviços e TLS em tudo, inclusive no tráfego interno.
O que o código dos outros pode fazer na sua página?
A CSP (Content Security Policy) é um header que diz ao navegador de onde a página pode carregar script, imagem e frame, e para onde ela pode fazer request. Se um script injetado tentar mandar dados para um domínio que não está na lista, o navegador bloqueia. Comece em modo de relatório (o header Content-Security-Policy-Report-Only), para não quebrar o site.
A SRI (Subresource Integrity) resolve outra coisa: garante que o arquivo que chegou é exatamente o que você revisou. Você coloca o hash no atributo integrity da tag <script> e, se um byte mudar, o navegador se recusa a executar. O hash se gera com openssl dgst -sha384 -binary arquivo.js | openssl base64 -A.
Os dois têm limite, e o AppsFlyer mostrou os dois. A CSP não ajuda quando o domínio sequestrado é justamente o que você autorizou. A SRI não funciona com SDK dinâmico, que muda dezenas de vezes por dia. Nesses casos, pelo menos saiba qual script está rodando, de onde vem, e quem aprova o que entra no tag manager.
A ofuscação do código cliente troca nomes, esconde strings e embaralha o fluxo para dificultar a leitura. Ela atrasa, não protege.
Em JS existe o javascript-obfuscator. No Flutter são duas flags (flutter build apk --obfuscate --split-debug-info=./symbols, guarde a pasta symbols para decifrar os stack traces), e no Android nativo o R8 (minifyEnabled true). Depois do que a gente viu aqui, uma IA desfaz isso em minutos, então trate como fricção e nunca como controle. E nunca, jamais, coloque segredo no cliente: se está no app ou no bundle, é público.
O RASP (Runtime Application Self-Protection) é um agente que vive dentro do seu app e observa o que ele está prestes a fazer, em vez de olhar só o HTTP que chegou. A diferença para o WAF é o contexto: o WAF vê q=' OR 1=1-- chegando num POST, já o RASP vê a query SQL que o app está prestes a executar, com a entrada da pessoa misturada, percebe que a estrutura da query mudou e bloqueia.
No backend é um agent plugado na inicialização (no Java, java -javaagent:/opt/rasp/agent.jar -jar app.jar), com hooks em SQL, acesso a arquivo, execução de processo e deserialização. Existem o OpenRASP (open source) e o Datadog App and API Protection, entre outros. No mobile, o RASP detecta hooking (Frida), root, jailbreak, emulador e adulteração do app e reage na hora, e dá para usar o freeRASP (open source, tem plugin Flutter) ou soluções como Promon e Guardsquare.
Quem pode fazer o quê?
- Privilégio mínimo: cada pessoa e cada serviço com o estritamente necessário para fazer o trabalho. Isso inclui o seu CI.
- 2FA em tudo que importa, de preferência resistente a phishing (passkey ou chave física). Lembra do registrador do AppsFlyer? Domínio e DNS são o seu bem mais valioso e o mais esquecido: ative transfer lock, restrinja quem acessa a conta e proteja o e-mail do contato.
- Banco de produção só via código: auditável, versionado, reversível e com aprovação proporcional ao tipo de consulta ou alteração. Ninguém abre um console e sai executando coisa à mão.
O Vault e os serviços de rotação automática de chaves merecem um parágrafo. Segredo que nunca é rotacionado é segredo que um dia vai vazar sem você saber. O HashiCorp Vault (e o fork open source OpenBao) vai além: os dynamic secrets geram uma credencial nova de banco para cada consumidor, com TTL, e o Vault a revoga sozinho quando o prazo acaba.
O AWS Secrets Manager tem rotação gerenciada (nativa para RDS e outros, o resto roda numa Lambda sua), o Azure Key Vault tem política de rotação automática para chaves, e o Google Secret Manager dispara um evento no Pub/Sub no agendamento para a sua função rotacionar. O Infisical (open source) também tem rotação para banco e IAM.
Rotacionar sozinho só vale se o seu app relê o segredo sem precisar de deploy. Lembra da Railway? É exatamente esse o gargalo.
Cuide dos headers. Eles costumam revelar implementação interna, stack, versão de servidor e de framework, e cada stack tem uma assinatura bem característica. Rode curl -sI https://seusite.com e veja o que o seu serviço conta sobre ele. Os suspeitos de sempre: X-Powered-By: PHP/8.1.2 (PHP), X-Powered-By: Express (Node), X-Powered-By: Next.js (Next, e o HTML cheio de /_next/static/), X-AspNet-Version (ASP.NET), Server: Apache-Coyote/1.1 (Tomcat, Java), X-Application-Context (Spring Boot 1.x) e o Link apontando para /wp-json/ (WordPress).
Um X-Powered-By: PHP/8.1 é um convite: o atacante não precisa testar, ele já sabe qual CVE tentar. Como esconder: expose_php = Off no PHP, server_tokens off; no nginx, ServerTokens Prod no Apache, app.disable("x-powered-by") no Express (ou o helmet) e poweredByHeader: false no next.config.js.
No Java, tire a versão do Tomcat das páginas de erro (server.xml) e limpe o que sobrar no gateway (no Kong, o plugin response-transformer com remove.headers). Para as páginas de erro do Tomcat, a ErrorReportValve com showServerInfo="false" resolve.
E aproveite que está mexendo em header para ligar os que protegem de verdade: Strict-Transport-Security, X-Content-Type-Options: nosniff, Referrer-Policy e Permissions-Policy.
Você enxerga o que está acontecendo?
- Logs estruturados, desde o início. Quando o incidente acontecer, você vai perguntar “quem acessou o quê, quando?”, e a resposta precisa ser uma consulta, não uma arqueologia.
- IaC (Terraform) para a infraestrutura e Pulumi (ou equivalente) para os alertas também virarem código: versionados, revisados, reproduzíveis.
- RUM (monitoramento de usuário real): é por ele que você nota o script do fornecedor que começou a fazer request estranha no navegador de gente de verdade.
- Monitore menções à sua empresa no Twitter, no Reddit e em fóruns especializados, e se tiver estômago, até em grupos mais escondidos. Repare que no caso do AppsFlyer o primeiro sinal público apareceu fora da empresa.
O que você tem rodando e consegue trocar rápido?
- Um inventário do que está em produção, com versão. O aviso do PHP diz que as versões 8.1 e anteriores não recebem mais atualização do projeto. Quantos serviços seus rodam isso hoje? Se a resposta é “preciso procurar”, essa é a primeira tarefa.
- Observabilidade com visão única como inventário vivo. No Datadog, por exemplo, você enxerga os clients com RUM, passa pelo APM e pelos logs e chega até a infra e o banco de dados (com o Database Monitoring), tudo na mesma ferramenta. O Service Map desenha sozinho a interação entre os sistemas e mostra os gargalos, e o Software Catalog lista cada serviço com dono e dependências. Com as tags
env,serviceeversion(o unified service tagging) fica fácil ter uma big picture de toda a empresa, sem que alguém tenha que desenhar na mão como os maias e astecas. Só lembre que a ferramenta mostra o que você instrumentou: a versão do runtime (o PHP 8.1 do caso) só vira filtro se você a expuser como tag. New Relic, Dynatrace e o stack da Grafana vão pelo mesmo caminho. - Um runbook de rotação: uma lista de todas as credenciais, onde ficam, quem pode rotacionar e como. Quanto mais próximo de “um comando”, melhor. Teste. E pense no que acontece se o seu provedor estiver com o pipeline travado, porque isso aconteceu comigo hoje.
2. O incidente
Quando acontece, você tem quatro perguntas, e a ordem importa.
- Detecção: como foi descoberto? Foi você, foi um fornecedor, foi um pesquisador ou foi um usuário reclamando em um fórum? Isso diz muito sobre a maturidade do seu monitoramento. No caso do AppsFlyer, a empresa afirma ter detectado a anomalia às 00:22 UTC do dia 10, mas pesquisadores já tinham visto o payload na noite do dia 9.
- Estancar: a vulnerabilidade já foi sanada? Antes de qualquer investigação refinada, pare o sangramento: isole, bloqueie, desligue, reverta. Se só existe mitigação parcial (como as do aviso do PHP, que os próprios autores dizem que “não tornam a instalação segura”), trate o incidente como ainda aberto.
- Impacto: por quanto tempo foi explorado e o que foi comprometido? Aqui as respostas costumam ser desconfortáveis. A AppsFlyer fala em pouco mais de nove horas na manhã do dia 10 (de 00:31 a 09:47 UTC); pesquisadores independentes suspeitam que a janela foi maior, entre a noite do dia 9 e o dia 11. Duas fontes, duas respostas, e o texto de quem sofreu o incidente sempre é o mais otimista. Parta do pior cenário que os seus logs não conseguem descartar.
- Priorização: o que precisa ser rotacionado e quem precisa ser avisado? Rotacione primeiro o que dá mais acesso (credenciais de nuvem, de banco, chaves de assinatura, tokens de pagamento) e depois o resto. Avise quem tem dados em risco, e se você trata dados pessoais de brasileiros, a LGPD exige comunicação à ANPD e aos titulares, com prazo curto. Não deixe para descobrir isso durante o incidente.
3. Pós-incidente
Post mortem. Linha do tempo dos acontecimentos, o que foi feito para estancar, os próximos passos, o que aprendemos e quais guardrails impedem que se repita. Escreva sem procurar culpado no texto, porque o objetivo é entender o sistema que permitiu o erro. Isso não é a mesma coisa que não ter responsabilização, e já já eu explico a diferença.
Transparência. Comunique quem foi envolvido, direta e indiretamente: clientes, parceiros, fornecedores, time. Rápido, claro, sem adjetivo, dizendo o que sabe e o que ainda não sabe. A Railway, mesmo no meio do caos, publicou a recomendação (rotacionar tudo) enquanto ainda investigava. Dá para criticar a demora, mas esse é o caminho certo.
Responsabilização. Sim, eu escrevi isso mesmo. Na época de ouro da engenharia de software, no boom das startups, quando era proibido demitir e podíamos ir de bermuda para o escritório pegar uma cerveja da geladeira cheia e de graça às 14h, isso era tabu, para não dizer terminantemente proibido. Eu considero primordial. Medidas precisam ser tomadas em relação a pessoas e sistemas, ao que quer que tenha aberto a brecha. Responsabilização não significa demissão (às vezes significa, como quando é intencional), e sim parte do amadurecimento do processo: reduzir os privilégios daquela pessoa, passar pelo treinamento obrigatório INSUPORTÁVEL de reciclagem que o time de segurança da informação tanto ama (e que de nada adianta, tá bom?), trocar de time para se expor menos. Isso faz parte do amadurecimento do profissional e da companhia. Com a devida comunicação, feedback e respeito, claro. Mas é imprescindível e sempre foi deixado de lado.
E o chaos engineering? Tudo o que eu listei lá em cima só vale se funcionar de verdade na hora. A única forma de saber é provocar um incidente controlado dentro de casa e ver como o time se comporta diante da crise: derrubar uma credencial de propósito, simular um fornecedor comprometido, rodar um game day de segurança em que alguém do time (ou de fora) tenta entrar de verdade. Você vai descobrir que o runbook está desatualizado, que ninguém sabe quem tem a senha do registrador, que o alerta não chega a ninguém às duas da manhã. É muito melhor descobrir isso numa terça de tarde do que durante o incidente real (e nunca numa sexta, nem de deploy, nem de incidente).
Beleza, Lukita, mas se eu vou ser hackeado de qualquer jeito, para que gastar tempo e dinheiro com tudo isso? Porque o objetivo nunca foi chegar a zero. É diminuir o blast radius e o tempo entre o ataque e a sua reação. Quem passou por isso com um runbook de rotação testado e logs que respondem perguntas gasta algumas horas. Quem passou sem eles gasta semanas, e ainda não tem certeza do que perdeu.
Vale lembrar
Este guia não tem a pretensão de ser completo, nem de ser verdade absoluta. Eu escrevi em um dia de incidente aberto, com os fatos do jeito que estavam publicados nas fontes abaixo, e vários deles ainda devem mudar (o próprio incidente da Railway segue em andamento). A leitura de que as ferramentas tradicionais não acompanham o ritmo dos modelos de fronteira é uma opinião minha, sem estudo por trás. E se uma empresa que faz tudo o que listei escapa de ser hackeada? A resposta óbvia é: não sei!
Lembra que eu falei no começo que eu já sei que vou ter o trabalho longo de rotacionar várias chaves quando a Railway liberar? Pois é, é exatamente isso. A diferença entre sofrer um incidente e ser pego de surpresa por ele é ter perguntado, antes, “e se acontecer agora?”. Se você quiser trocar ideia, discordar de algum item ou contar o que o seu time faria nos primeiros 60 minutos, comenta aqui.
Fontes
- PHP: aviso de segurança de 21/10/2026
- Wiz Research: PHP2Shell
- Railway: security disclosure de 21/10/2026 e página do incidente
- AppsFlyer: FAQ do incidente de março de 2026
- BleepingComputer: AppsFlyer Web SDK used to spread crypto stealer JavaScript code
- cside: análise técnica do payload
- Profero: Hijacked at the Source
- Thread no Hacker News e o paste do script analisados pelo Gemini e pelo Claude