decision_ai: uma lib Flutter para decisões jev-style, via API ou com inferência local
Como instalar, inicializar, casos de uso, quais modelos já funcionam e como otimizar, no celular, no navegador ou atrás de uma API.
Uma lib Flutter para decisões tipadas no estilo do Jev: o mesmo código para chamar uma API ou rodar o modelo dentro do app, no celular ou no navegador.
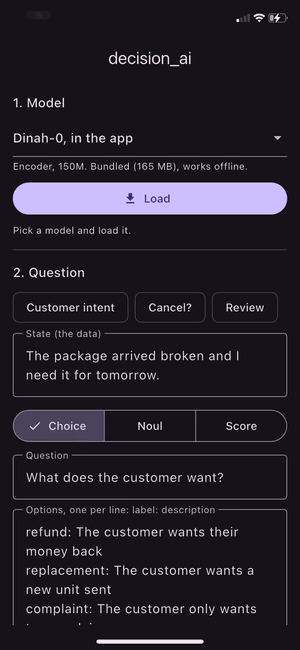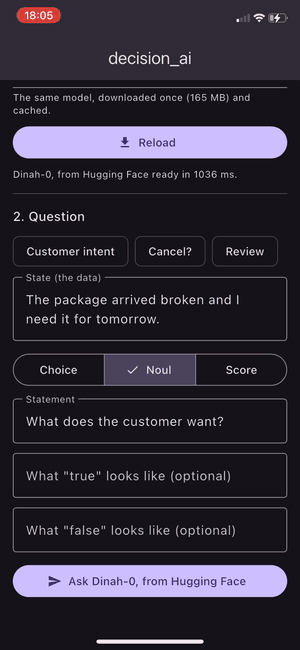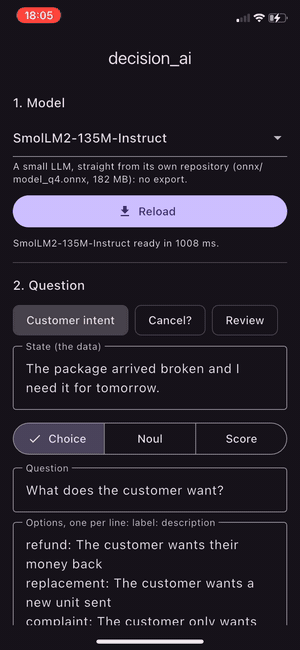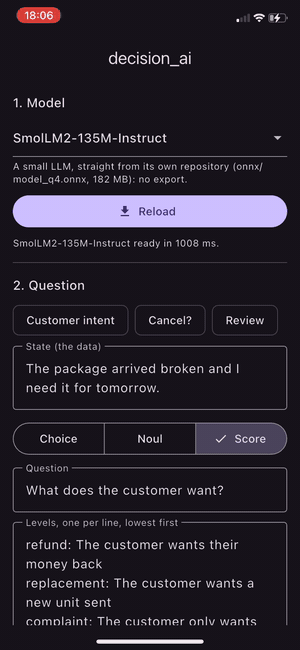
Se você leu o post da Dinah-0, sabe que eu terminei com uma pergunta: em vez de “qual é o maior modelo que podemos colocar aqui?”, talvez valha perguntar “qual é o menor modelo que aprendeu exatamente o que precisamos?”. Pois é, se a Dinah cabe no CPU do meu Mac, ela cabe no bolso de alguém, certo? Então eu fiz a lib que faltava para isso: a decision_ai.
Este post é o guia dela: o que ela resolve, como instalar, as formas de inicializar e quando usar cada uma, os modelos que já funcionam e o que eu aprendi sobre otimização no caminho (algumas coisas do jeito difícil).
O que ela resolve
Decidir é sempre a mesma coisa: você tem um estado (um texto ou um JSON) e perguntas tipadas sobre ele. São os três tipos do Jev:
| tipo | você passa | você recebe |
|---|---|---|
Choice | rótulos, cada um com uma descrição opcional | o rótulo escolhido, a probabilidade de cada um e a confiança |
Noul | uma afirmação (e, se quiser, como é o “verdadeiro” e o “falso”) | a probabilidade de a afirmação ser verdadeira |
Score | níveis em ordem, do menor para o maior | o nível esperado (de 0 a n-1) e a probabilidade de cada nível |
Nenhum texto é gerado e nada é parseado: cada resposta sai de uma única passada do modelo, que dá nota para cada opção.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
final ai = await DecisionAI.huggingFace('Lukitaduarte/dinah-0');

final answers = await ai.decide(
  state: 'The package arrived broken and I need it for tomorrow.',
  questions: {
    'intent': const Choice({
      'refund': 'The customer wants their money back',
      'replacement': 'The customer wants a new unit sent',
      'complaint': 'The customer only wants to complain',
    }, instructions: 'What does the customer want?'),
    'urgent': const Noul('The customer needs it soon.'),
  },
);

answers['intent']!.choice;        // 'replacement'
answers['intent']!.probabilities; // {refund: 0.002, replacement: 0.971, complaint: 0.027}
answers['urgent']!.noul;          // probabilidade de a afirmação ser verdadeira
Instalação
1
2
dependencies:
  decision_ai: ^1.0.0
O pacote está no pub.dev: pub.dev/packages/decision_ai.
Cada plataforma pede um ajuste pequeno, e todos vêm do runtime que roda o modelo por baixo, o ONNX Runtime 1.23:
- iOS (16 ou mais novo): no
ios/Podfile,platform :ios, '16.0'euse_frameworks! :linkage => :static. - Android: a permissão
android.permission.INTERNETnoAndroidManifest.xmlprincipal, se o app baixa modelo ou chama API (o Flutter só coloca essa permissão no build de debug, e isso quebra o app publicado em silêncio), e a regra-keep class ai.onnxruntime.** { *; }noproguard-rules.pro, para o build de release. - Web: os arquivos do
onnxruntime-web@1.23.0(ort.wasm.min.js,ort-wasm-simd-threaded.mjseort-wasm-simd-threaded.wasm) emweb/ort/, carregados noindex.htmlantes doflutter_bootstrap.js.
As formas de inicializar, e quando usar cada uma
Toda forma devolve a mesma interface, o DecisionEngine, então trocar de uma para outra não muda o resto do código. Essa foi a premissa número um da lib.
1. Modelo dentro do app:
1
final ai = await DecisionAI.local(); // lê assets/model/decision_ai.json
Use quando o app precisa funcionar offline desde a primeira abertura e o tamanho do pacote não é problema. A Dinah soma 165 MB ao app.
Só não esqueça de declarar as pastas do modelo como assets no pubspec.yaml do seu app. O Flutter só empacota o que está declarado, e uma pasta não inclui as subpastas, então cada uma precisa da própria linha:
1
2
3
4
flutter:
  assets:
    - assets/model/        # decision_ai.json e tokenizer.json
    - assets/model/onnx/   # o arquivo do modelo
Sem isso, o app compila normalmente e só quebra quando tenta carregar o modelo, com um “Unable to load asset”.
2. Baixado do Hugging Face na primeira vez:
1
2
3
4
5
final ai = await DecisionAI.huggingFace(
  'Lukitaduarte/dinah-0',
  revision: '07c6884439df7c3d2cd01eea16924ed07b866dea',
  onProgress: (file, received, total) => print('$file: $received de $total'),
);
Use quando você quer um app pequeno na loja. O modelo é baixado uma vez, conferido por SHA-256, fica em cache e funciona offline depois. Se eu puder te dar uma dica: fixe a revision num commit. Sem isso, o modelo pode mudar por baixo do seu app no dia em que alguém atualizar o repositório.
3. De qualquer servidor HTTP:
1
final ai = await DecisionAI.remote(ModelSource.url('https://cdn.seu-dominio.com/modelos/dinah/'));
É a mesma coisa do Hugging Face, só que do seu CDN ou bucket. Use para modelos privados ou quando você quer controlar a distribuição.
4. No navegador: as mesmas chamadas huggingFace e remote funcionam na web. O modelo roda em WebAssembly, num worker, e o navegador faz o cache. Use para demos e para produtos web sem backend.
5. Atrás de uma API:
1
2
final ai = DecisionAI.api(endpoint: 'https://provedor.com/v1/systemone', apiKey: key, model: 'modelo');
final ai = DecisionAI.openRouter(apiKey: key, model: 'provedor/modelo');
Use quando a decisão precisa de um modelo grande: conhecimento de mundo, raciocínio longo, textos enormes. Aqui a lib é só um cliente tipado do formato de decisões.
6. Montando as peças na mão:
1
final ai = DecisionAI.custom(runtime: meuRuntime, reader: meuReader, calibrator: meuCalibrador);
Para quando você quer outro motor de inferência (TFLite, Core ML, llama.cpp) ou um formato de modelo que a lib não conhece.
Resumindo a escolha:
| situação | forma |
|---|---|
| offline desde o primeiro uso | local() |
| app pequeno, modelo aberto | huggingFace() com revision fixa |
| modelo privado ou CDN próprio | remote() |
| sem instalar nada | as mesmas chamadas, na web |
| a decisão precisa de um modelo grande | api() ou openRouter() |
Modelos suportados
Por dentro, um modelo local é feito de quatro peças trocáveis: um Runtime (ONNX Runtime no celular, ONNX Runtime Web no navegador), um Tokenizer, um Calibrator e um Reader. O reader é o que muda de uma família de modelos para outra: ele sabe montar a pergunta no formato que o modelo aprendeu e ler a nota de cada opção. A lib traz três: option-reader (Dinah), laya (Laya) e label-logits (LLMs).
Cada linha abaixo foi conferida pergunta por pergunta contra o código Python original, nas mesmas 64 perguntas:
| modelo | tipo | tamanho | iOS | Android | navegador |
|---|---|---|---|---|---|
| Dinah-0 | encoder, 150M | 165 MB | 64/64 | 64/64 | 63/64 |
| SmolLM2-135M-Instruct | LLM, 135M | 182 MB (arquivo do próprio repo) | 64/64 | 64/64 | 63/64 |
| Laya | encoder ModernBERT-large, 421M | 275 MB (port da comunidade em 4 bits) | 64/64 | 62/64 | 62/64 |
| Verdict | encoder GLiClass, 151M | 606 MB | 64/64 | 64/64 | não medido |
| Qwen2.5-0.5B-Instruct | LLM, 494M | 694 MB (export próprio) | 64/64 | 64/64 | não medido |
Num iPhone XR de verdade (de 2018), a Dinah responde em 0,93 s por pergunta e bate com o Python em 64 de 64. No navegador, ela leva cerca de 0,9 s. As diferenças no navegador vêm de um detalhe do JavaScript: lá, 532.0 e 532 são o mesmo número, então o modelo recebe 532 onde o Python escreveu 532.0. Na Laya, os kernels de 4 bits também mudam um pouco as contas no Android e no navegador.
O Verdict, aliás, entra no app de exemplo com um reader que o próprio app registra. É o exemplo de como plugar uma família que a lib não conhece:
1
DecisionAI.registerReader('gliclass', GliClassReader.new);
Como trazer qualquer modelo do Hugging Face
Aqui eu apanhei até entender uma coisa simples: o único “port” obrigatório é o reader. Exportar o modelo é escolha.
Muitos repositórios já publicam arquivos ONNX prontos (o SmolLM2 tem uma pasta onnx/). Para esses, um comando gera o manifesto lendo o config.json, sem exportar nada:
1
2
python tool/export_causal_lm.py manifest --model HuggingFaceTB/SmolLM2-135M-Instruct \
  --onnx onnx/model_q4.onnx --template-file template.txt --out smollm2
E quando vale exportar? Medimos os dois caminhos no SmolLM2:
| tamanho | respostas iguais ao fp32 | por pergunta (iOS / Android) | |
|---|---|---|---|
| ONNX do próprio repo, sem export | 182 MB | 45 de 64 | 611 / 1.101 ms |
| export com o nosso script | 181 MB | 64 de 64 | 237 / 259 ms |
Os dois rodam exatamente como o Python. A diferença é que o arquivo publicado está em 4 bits e devolve as notas de todas as posições do texto, enquanto o export guarda os pesos em 8 bits e devolve só a última posição, que é a que importa. No Qwen2.5 essa diferença deixou de ser detalhe: o arquivo publicado devolve 151 mil notas por token, e o Android matou o app por falta de memória. Com o export, ele roda nos dois sistemas em cerca de 1 s por pergunta.
Então o desenho ficou assim: a lib dá os mecanismos, e cada um pega o modelo original e usa do jeito que quiser, otimizando ou não.
Recomendações de otimização
Tudo o que está aqui foi medido, e quase tudo eu descobri porque algo deu errado antes:
- Pesos em 8 bits, com a conta em fp32. É o melhor equilíbrio que encontrei: um quarto do tamanho e 64 de 64 respostas iguais. Deixe o
accuracy_leveldoMatMulNBitssem definir. Comaccuracy_level=4, que quantiza também as ativações, o iOS deu 64 de 64 e o Android 61 de 64, porque os dois builds do ONNX Runtime usam kernels diferentes. - Fuja da quantização dinâmica em int8. O mesmo problema, pior: no ONNX Runtime 1.23, a Dinah em int8 dinâmico concordou com o fp32 em só 75,7% das respostas.
- Compare sempre com o fp32 antes de escolher. Nem todo modelo aguenta quantização: o Verdict em 8 bits mudou 10 de 64 respostas, então ele roda em fp32.
- Num LLM, devolva só a última posição. É isso que deixa o export até 4 vezes mais rápido que o arquivo publicado, e é o que evita estourar a memória.
- Tamanho do modelo contra a RAM do aparelho. Um modelo de 700 MB que devolve centenas de MB por pergunta não cabe num celular comum. Na dúvida, teste no Android, que é o primeiro a matar o app.
- Fixe a
revisionde tudo que vem do Hugging Face. - Na web, sirva tudo do seu próprio site (
flutter build web --no-web-resources-cdn, mais oonnxruntime-webe as fontes locais). O Brave Shields bloqueia scripts de CDN e deixa a página em branco. A inferência já roda num worker: sem isso, o navegador trava a página a cada pergunta. - Nada é cortado. Se a pergunta não cabe no contexto do modelo, a lib lança
RequestTooLong. Prefiro um erro claro a uma resposta sobre metade do texto.
E uma lição que vale para qualquer port: teste que passa não prova nada, o que prova é comparar com o original. Foi comparando com o Python que achamos um tokenizer de referência errado, o Android discordando do iOS, e a Dinah jogando meio cega no navegador por causa de uma única linha (1 << 62 vira zero quando o Dart é compilado para JavaScript, e isso desligava todas as fusões do tokenizer: só 14 de 64 respostas batiam, até a correção).
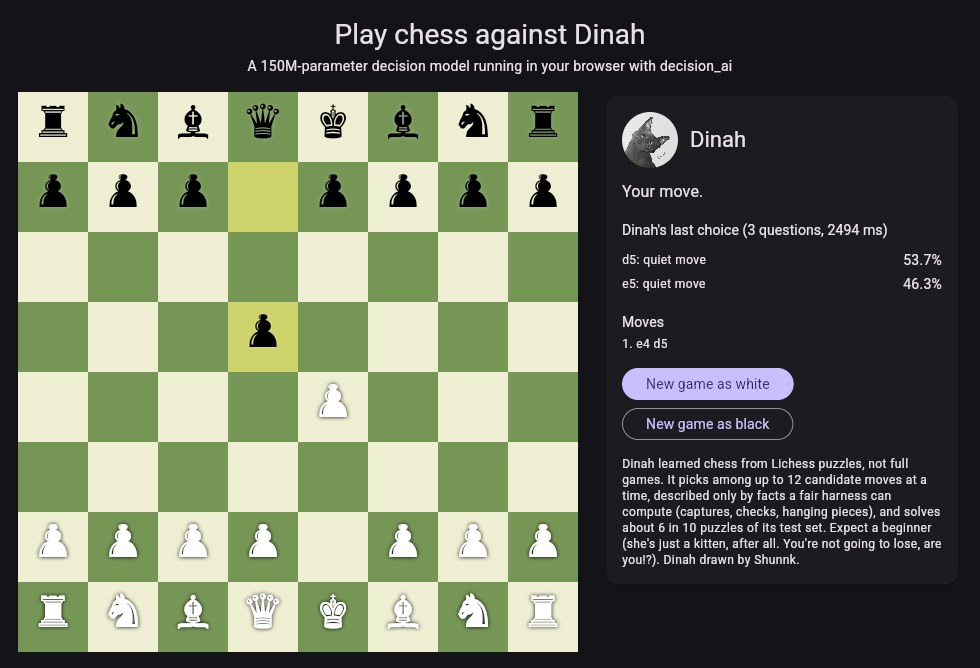
Jogue xadrez contra a Dinah
Para mostrar tudo isso rodando, fizemos duas demos no navegador:
- Play chess against Dinah: você joga contra a Dinah-0, inteira no seu navegador.
- Playground: você escolhe um dos modelos abertos da tabela e faz as suas próprias perguntas.
A Dinah aprendeu xadrez com puzzles do Lichess, escolhendo entre no máximo 12 lances, descritos só com fatos que um árbitro honesto calcularia (captura, xeque, peça pendurada). Ela resolve cerca de 6 em cada 10 puzzles do conjunto de teste. Então espere uma iniciante (afinal, é apenas uma gatinha, né? Você não vai perder, vai!?).
Eu empatei uma partida ganha contra ela, por afogamento. Estava com torre, dama, bispo e cavalo contra o rei sozinho dela, dei um lance de bispo que fechou a última casa sem dar xeque, e o jogo terminou empatado. Ela nem precisou fazer nada, só ficou ali, olhando, como qualquer gata faz. Moral da história: a demo agora explica na tela quando um empate é regra oficial do xadrez, e eu aprendi a dar xeque antes de encurralar.
Vale lembrar
A decision_ai não tem a pretensão de deixar um modelo mais inteligente. Ela roda o modelo com fidelidade, e só. Modelos pequenos erram mais, e LLMs pequenos são decisores fracos. Também vale lembrar que:
- tokenizers do tipo SentencePiece (T5, Gemma, Llama 2) ainda não vêm prontos;
- no navegador, números inteiros escritos como decimal (
532.0) mudam uma resposta aqui e ali; - a Dinah-0 é CC BY-NC (uso não comercial). A lib é MIT, e cada modelo tem a própria licença.
Cada caso é um caso. Se a sua decisão precisa de um modelo grande, a mesma interface fala com uma API.
Obrigado
Isso só foi possível porque outras pessoas abriram o próprio trabalho: a Convai Innovations com a Laya, os autores do Verdict, o time do SmolLM2, o Qwen, o plugin flutter_onnxruntime e o ONNX Runtime. E a Dinah do avatar das demos foi desenhada por @shunnk0.
O pacote está em pub.dev/packages/decision_ai e o código em github.com/Lukitaduarte/decision_ai, com um guia para coding assistants trazerem modelos novos. Se quiser testar, portar um modelo ou só perder uma partida para a gatinha, comenta aqui.